Do pedido de uma linha à spec viva: spec-driven development na prática
- Por Bruno Souza
- Engenharia com AI
- 17 min de leitura
Nesta página
Código
Um pedido de uma linha
Imagine a equipe de logística de uma loja online. Ela precisa que o atendimento consulte a entrega de um pedido sem abrir três sistemas, e manda para o time de desenvolvimento uma mensagem de uma linha:
Precisamos de uma API que, dado o número do pedido, retorne o status da entrega.
A cena é inventada, mas o pedido tem a forma da maioria dos pedidos reais: curto, razoável e incompleto. Ele não diz o que é um número de pedido. Só dígitos? PED-123 vale? E 01001, é o mesmo pedido que 1001? Também não diz quais status existem, o que a resposta traz além do status, nem o que acontece quando o pedido não existe: erro do cliente, recurso não encontrado ou um status “desconhecido”?
Quem programa responde a essas perguntas enquanto escreve o código, quase sempre sem perceber. Um agente de IA faz a mesma coisa, só que mais rápido: escolhe um formato, escolhe um código de erro, entrega algo que funciona e segue em frente. As decisões existem, mas ficaram dentro do código, e ninguém as aprovou.
Este artigo acompanha esse pedido do começo ao fim com spec-driven development (SDD), usando o OpenSpec. O projeto é real e público, em brunosouzas/spec-driven-delivery-api: uma API Mule 4 pequena, construída em duas mudanças. Cada trecho de spec, comando e resposta mostrado aqui vem desse repositório, e o histórico de commits guarda cada versão.
O que é spec-driven development
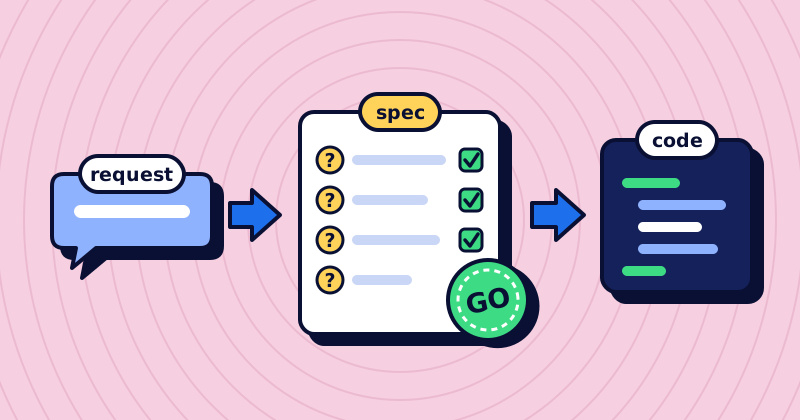
Birgitta Böckeler, da Thoughtworks, resume a ideia numa frase: SDD é escrever uma spec antes de escrever código com IA, e essa spec passa a ser a fonte de verdade tanto para a pessoa quanto para a IA (martinfowler.com, outubro de 2025). A spec descreve o comportamento esperado: o que entra, o que sai, o que acontece nos casos de erro. O agente implementa a partir dela.
Na prática, isso muda quem decide: quem aprova a spec decide o que o sistema faz.
O Thoughtworks Technology Radar colocou SDD no anel Assess em novembro de 2025, como abordagem emergente cuja definição ainda está em evolução. Em comum, essas abordagens começam por uma especificação funcional estruturada e a quebram, em etapas, em partes menores, soluções e tarefas.
A ideia de fundo é bem mais antiga que os agentes. Em 1986, num relatório técnico, Bertrand Meyer descreveu o Design by Contract: cada rotina declara pré-condições, pós-condições e invariantes, e esse contrato é a especificação do que ela promete. Em 2004, Jonathan Ostroff, David Makalsky e Richard Paige já usavam o nome no artigo Agile Specification-Driven Development, apresentado na conferência XP. Eles combinavam TDD com contratos e defendiam que testes e contratos são dois tipos de especificação. A novidade de agora é quem lê a spec: além das pessoas, um agente que escreve o código a partir dela.
Há várias ferramentas para isso. Böckeler analisou Kiro, spec-kit (do GitHub) e Tessl. Este exemplo usa o OpenSpec, na versão 1.14.1, que organiza o trabalho em mudanças, as changes, num ciclo de três passos principais: propor (/opsx:propose), aplicar (/opsx:apply) e arquivar. Antes de propor, há ainda um passo opcional de exploração. O que vem a seguir vale, com outros nomes, para as outras ferramentas.
Preparando o projeto
Tudo começa com um comando na raiz do repositório:
openspec init --tools noneSem a opção --tools, o init pergunta quais assistentes de IA você usa e instala para cada um os comandos do fluxo, como /opsx:propose. Aqui a opção foi none porque os agentes do exemplo já estavam configurados por fora. O resultado é uma pasta openspec/ dentro do projeto, ao lado do código:
openspec/
├── config.yaml
├── specs/
└── changes/
└── archive/specs/descreve o que o sistema faz hoje. No começo está vazia, porque o sistema ainda não faz nada.changes/guarda as mudanças em andamento, uma pasta por change.changes/archive/recebe as changes concluídas, com a data no nome.config.yamldá o contexto do projeto e as regras que todo artefato segue.
É no config.yaml que o projeto ensina o agente a propor. Neste exemplo ele diz que a API é Mule 4, que os dados ficam numa variável em vez de um banco e que cada cenário vai ser provado com uma chamada real. Ele também traz regras por artefato. Três delas fazem diferença no resto da história:
rules:
  proposal:
    - State what is out of scope.
    ...
    - When the request is unclear, list the open question instead of choosing an answer.
  specs:
    ...
    - Describe observable HTTP behaviour (status, body, headers), not implementation.
No repositório: openspec/config.yaml
A regra das perguntas abertas é a mais importante. Ela proíbe o agente de fazer o que faria por padrão, que é escolher em silêncio.
Fora da pasta, o repositório tem duas proteções simples. O AGENTS.md diz a qualquer agente que o trabalho vem de uma change aprovada e que, se faltar uma decisão, ele para e pergunta. E um workflow de CI roda openspec validate --all --strict em todo pull request, o que barra uma spec malformada antes do merge.
A primeira change
Com o projeto preparado, o pedido de uma linha foi entregue ao Claude, numa sessão limpa, com o comando de proposta do OpenSpec (/opsx:propose). Ainda não existe código. O que sai é uma change chamada add-delivery-status:
openspec/changes/add-delivery-status/
├── proposal.md
├── design.md
├── tasks.md
└── specs/
    └── delivery-status/
└── spec.mdproposal.mddiz por que a mudança existe, o que muda, o que fica de fora e o que ainda não se sabe.specs/delivery-status/spec.mdé o delta: os requisitos que esta change acrescenta ao sistema, cada um com cenários no formato WHEN/THEN.design.mdregistra decisões técnicas. Aqui ficou com poucas linhas, porque não havia alternativa técnica real para escolher.tasks.mdlista o trabalho, e cada tarefa diz como vai ser verificada.
A proposta sugeriu um caminho, GET /api/orders/{orderNumber}/delivery-status, e respostas para pedido inexistente e número malformado, mas marcou cada sugestão como proposta e listou o que a frase não respondia:
## Open Questions

1. **Order number format**: digits only? Length? Prefixes such as `PED-123`?
2. **Status values**: which statuses exist, and in Portuguese or English?
3. **Response content**: only the status, or also fields like last update time?
4. **Unknown order**: `404`, or `200` with an "unknown" status?
5. **Consumers and access**: who calls the API, and does it need authentication?
6. **Path and naming**: is there an existing URL convention to follow?
São as mesmas perguntas da abertura, agora escritas, numeradas e endereçadas a quem pode respondê-las. A seção Out of Scope fez o trabalho inverso: deixou explícito que criar ou cancelar pedidos, histórico de rastreio, autenticação e integração com sistemas reais não fazem parte do pedido.
Responder, revisar, aprovar
A equipe de logística respondeu às seis perguntas. O número do pedido tem só dígitos, de 1 a 20. Os status são PENDING, IN_TRANSIT e DELIVERED, em inglês. A resposta de sucesso tem dois campos, orderNumber e status. Pedido que não existe recebe 404.
A última resposta teve debate. A dúvida era se um pedido inexistente é um erro de negócio (400) ou um recurso que não foi encontrado (404). As duas leituras se defendem. A proposta registra a decisão e o motivo: o pedido é o recurso que a URL nomeia, e esse recurso não existe; o 400 fica para requisições malformadas. Sem a spec, quem implementasse escolheria uma das duas em silêncio, e a equipe de logística só descobriria qual ao receber o primeiro erro.
Com as respostas no lugar, a change passou por uma revisão independente. Outro agente, o Codex, numa sessão limpa e só com permissão de leitura, recebeu uma pergunta: alguém sem nenhum outro contexto conseguiria implementar exatamente o comportamento pretendido só com esses artefatos? Os achados eram classificados como bloqueador, maior ou menor, e o veredito era GO ou NO-GO.
O primeiro veredito foi NO-GO, com quatro achados maiores:
- A spec aceitava zeros à esquerda, mas não dizia se
01001identifica o pedido1001. - Métodos como
POSTno endpoint não tinham contrato nenhum. - A regra “só dois campos na resposta” contradizia as respostas de erro, que traziam um campo
message. - As tarefas de verificação não cobriam o comportamento todo: nenhum teste de 20 dígitos, nenhum caso de zero à esquerda, um status só.
A versão seguinte corrigiu os quatro, e a segunda revisão também deu NO-GO, agora por detalhes mais finos. A regra “qualquer método que não seja GET recebe 405 com corpo JSON” incluía o HEAD, e uma resposta a HEAD não pode ter corpo. E POST /api/orders/abc/delivery-status caía em duas regras ao mesmo tempo: número malformado (400) e método não suportado (405). Dependendo da ordem das validações, duas implementações corretas dariam respostas diferentes.
A quarta versão fechou os dois pontos: POST, PUT, PATCH e DELETE recebem 405 antes de qualquer validação do número, e HEAD e OPTIONS ficaram fora do escopo. A decisão sobre zeros à esquerda virou requisito e cenário:
#### Scenario: Leading zeros are a different identifier
- **WHEN** a client sends `GET /api/orders/01001/delivery-status`, order `1001` exists and no order `01001` exists
- **THEN** the API responds `404`
- **AND** the body is `{"message": "Order 01001 not found"}`
No repositório: openspec/changes/archive/2026-10-09-add-delivery-status/specs/delivery-status/spec.md
Duas reprovações podem parecer desperdício. Todas as correções, porém, foram feitas em algumas linhas de markdown, antes de existir uma linha de código. Os mesmos problemas, descobertos depois, seriam bugs em produção ou discussões com quem consome a API. A precedência entre 400 e 405, por exemplo, só aparece quando alguém faz a combinação exata de método errado com número inválido.
A aprovação, por fim, é de um commit específico da change, o da quarta versão. Abrir o pull request ou passar na validação não conta como aprovação: só a decisão explícita de quem é dono do pedido libera a implementação.
Implementar e provar
A partir daí, o agente implementa o que as tarefas dizem e nada além; no fluxo do OpenSpec, esse é o passo /opsx:apply. O AGENTS.md não deixa replanejar uma change aprovada, e uma decisão que a change não tomou é motivo para parar e perguntar. Neste caso não foi preciso, porque a spec já respondia a tudo.
O resultado é um fluxo Mule de cerca de 50 linhas. Um listener HTTP recebe a chamada, e uma transformação em DataWeave decide a resposta. Os pedidos ficam numa variável que faz o papel do banco de dados. A ordem das verificações repete a spec:
if (attributes.method != "GET")
  { code: 405, body: { message: "Method not allowed" } }
else if (!(orderNumber matches /[0-9]{1,20}/))
  { code: 400, body: { message: "Invalid order number: $(orderNumber)" } }
else if (orders[orderNumber] == null)
  { code: 404, body: { message: "Order $(orderNumber) not found" } }
No repositório: src/main/mule/delivery-status.xml
Quem leu a seção anterior reconhece cada linha: o método vem primeiro por causa da segunda revisão, o formato tem de 1 a 20 dígitos por causa da resposta da logística, e o 404 cobre o pedido inexistente pelo motivo que ficou registrado na proposta.
A prova não usa testes automatizados. Cada cenário da spec vira uma chamada curl contra a aplicação rodando, e a resposta real fica registrada no README. A spec final tem dez cenários, e nove chamadas cobrem todos: o formato do corpo de erro aparece em cada resposta de erro. Duas delas mostram as decisões que a revisão forçou:
$ curl -si http://localhost:8081/api/orders/01001/delivery-status
HTTP/1.1 404 Not Found
content-type: application/json

{
  "message": "Order 01001 not found"
}

$ curl -si -X POST http://localhost:8081/api/orders/abc/delivery-status
HTTP/1.1 405 Method Not Allowed
content-type: application/json

{
  "message": "Method not allowed"
}
No repositório: README.md
O curl é uma escolha do exemplo: deixa a prova legível no README, e qualquer pessoa consegue repeti-la. Num projeto real, cada cenário vira também um teste automatizado (no Mule, um teste MUnit) que roda no CI. A resposta registrada prova o comportamento no dia da entrega; o teste impede que ele quebre na mudança seguinte.
Com as tarefas concluídas, a change é arquivada:
openspec archive add-delivery-statusO arquivamento faz duas coisas. Move a pasta da change para changes/archive/2026-10-09-add-delivery-status/, onde ela fica como registro de como a decisão foi tomada. E incorpora o delta em openspec/specs/delivery-status/spec.md. A pasta specs/, vazia desde o init, agora descreve o que a API faz. É a spec viva: o próximo pedido começa dela, não do código nem da memória de alguém.
O segundo pedido
Alguns dias depois, na história, a logística volta com mais uma linha:
Agora precisamos mostrar também a data prevista de entrega.
Parece o tipo de mudança que não precisa de cerimônia: um campo a mais no JSON. A change add-estimated-delivery-date foi proposta da mesma forma, por um agente numa sessão limpa, mas desta vez com algo que a primeira não tinha: a spec viva. O agente leu o que a API já prometia e propôs um delta que modifica um requisito existente, em vez de criar outro:
## MODIFIED Requirements

### Requirement: Return delivery status by order number
...
A successful response SHALL have status `200`,
header `Content-Type: application/json` and a body with exactly three fields:
`orderNumber`, `status` and `estimatedDeliveryDate` ...
No repositório: openspec/changes/archive/2026-10-09-add-estimated-delivery-date/specs/delivery-status/spec.md
As perguntas abertas foram de novo as que a frase não respondia. Um pedido entregue mostra a estimativa antiga, a data real (que seria outro campo), nada ou nenhum campo? Um pedido pendente pode estar sem estimativa? A data tem hora e fuso? É um valor fixo ou calculado?
A seção de impacto trazia o que ninguém tinha pedido:
- Breaking for clients that reject unknown fields: the body no longer has
  "exactly two fields".
No repositório: openspec/changes/archive/2026-10-09-add-estimated-delivery-date/proposal.md
A spec da primeira change prometia que a resposta de sucesso tinha exatamente dois campos. Ninguém lembraria disso numa revisão de código que acrescenta uma linha a um JSON. O pedido não falava em contrato, e quem pediu a data provavelmente nem sabia que existia essa promessa. A spec sabia: ela mostra o que o pedido esqueceu. Um cliente que valida o corpo de forma estrita e recusa campos desconhecidos quebraria no dia do deploy.
Avisado antes do código, o dono do pedido aceitou a quebra de propósito e registrou o motivo na proposta. Para este exemplo, versionar a API seria mais mudança do que o pedido pedia. Em outro contexto, a mesma informação poderia levar a uma v2 ou a uma conversa com os consumidores.
As outras respostas também ficaram registradas: pedido entregue recebe null, pedido pendente ou em trânsito sempre tem data, a data não tem hora (YYYY-MM-DD) e o valor é fixo por pedido. A revisão independente deu GO na primeira rodada, com um único achado menor: a redação do requisito permitia uma data para pedido entregue, ao contrário do que a proposta decidia. A correção foi uma frase. Depois vieram a implementação, os curl refeitos e o arquivamento. Para passar no validador do OpenSpec, que limita o tamanho de cada requisito, o requisito consolidado foi dividido em dois na spec viva, sem mudar comportamento nem cenários. Hoje ela diz “exactly three fields”.
O que o exemplo ensina e quando não vale
O exemplo é pequeno de propósito, mas mostra quatro mecanismos que valem para sistemas maiores.
A spec viva é o primeiro. openspec/specs/ descreve o comportamento atual do sistema em requisitos e cenários, e cada change arquivada a atualiza. Quem chega ao projeto, pessoa ou agente, lê ali o que a API promete, sem precisar deduzir a partir do código.
O segundo é o delta em vez da reescrita. A segunda change não reescreveu a spec: declarou qual requisito modificava e manteve os outros intactos. A revisão olha só o que muda, e a comparação com o que existia é o que faz o impacto aparecer.
O terceiro é a revisão antes do código. As duas reprovações da primeira change custaram edições em markdown, não retrabalho. Ela não substitui a revisão do código: neste exemplo, a revisão independente ficou na spec; num projeto real, o diff também passa por um revisor, que confere a implementação contra os cenários.
O quarto é a prova por cenário. Cada cenário tem uma verificação que qualquer pessoa repete: aqui, o curl; num projeto real, o teste no CI.
Na classificação de Böckeler, há três níveis de SDD. No spec-first, a spec é escrita antes e usada na tarefa em questão. No spec-anchored, ela é mantida depois da tarefa e usada para evoluir o sistema. No spec-as-source, a spec vira a fonte principal e as pessoas não editam o código diretamente. Este exemplo fica no segundo nível: a spec continua depois da entrega e é o ponto de partida da mudança seguinte, mas o código ainda é código, revisado e editável.
Nada disso sai de graça. A primeira change levou quatro versões e duas revisões para um fluxo de 50 linhas. Böckeler conta que, ao pedir ao Kiro para corrigir um bug pequeno, o fluxo pareceu usar uma marreta para quebrar uma noz, e observa que revisar muitos arquivos de markdown pode ser mais cansativo do que revisar o código. Liu Shangqi, também da Thoughtworks, lembra que specs formalizadas demais podem atrapalhar e desacelerar os ciclos de mudança e feedback, como aconteceu nos primeiros tempos do desenvolvimento em cascata, embora ele mesmo acredite que desta vez é diferente (dezembro de 2025). O próprio Radar aponta o risco de reaprender que escrever à mão regras detalhadas para a IA não escala.
A crítica da burocracia procede para trabalho pequeno. Mesmo assim, depois de alguns bons anos escrevendo código, a minha experiência é que o que parece burocrático hoje pode salvar você amanhã, num bug, numa melhoria ou numa feature nova. Documentação é burocracia para muita gente até o dia em que alguém precisa dela, com detalhes. A segunda change deste exemplo é esse dia: a promessa de “exactly two fields” só apareceu porque estava escrita. E é por isso que, para mim, vale: o processo começa com um requisito e termina com artefatos que servem para tocar o projeto, com ou sem IA.
Um critério prático ajuda a decidir quando abrir uma change: abra quando quem usa o sistema vai precisar saber da mudança, como um endpoint novo, uma regra de negócio, um campo ou um contrato. Os dois pedidos deste exemplo passam no critério: o primeiro cria um endpoint, o segundo muda um contrato.
Corrigir um bug que devolve um comportamento já especificado, ajustar um log, atualizar uma dependência ou refatorar sem mudar comportamento não pede change; o pull request é o registro. Nesses casos, a spec só atrasaria o trabalho. Na dúvida, comece sem change; se a revisão mostrar que o comportamento muda, abra uma antes do merge.
Como a história terminou
A equipe de logística tem a API que pediu: GET /api/orders/{orderNumber}/delivery-status devolve o status e a data prevista de entrega. Cada cenário da spec tem prova numa chamada real registrada no README. As decisões que a frase de uma linha não tomava estão escritas: o formato do número, o 404 para pedido inexistente, o 405 antes de qualquer validação, o null para pedido entregue e a quebra de contrato aceita de propósito, com o motivo ao lado.
Quando o próximo pedido chegar, quem pegar o trabalho começa por openspec/specs/delivery-status/spec.md, que diz o que a API faz hoje, e por openspec/changes/archive/, que mostra por que ela faz assim.
Para ver o processo por dentro, clone o repositório e leia nesta ordem: a spec viva, as duas changes arquivadas e os comentários de revisão nos pull requests #1 e #4. O histórico de commits mostra cada versão da proposta, da primeira, escrita a partir de uma linha, até a que foi aprovada. Depois, escolha um pedido curto do seu próprio backlog, rode openspec init num projeto pequeno e veja quantas perguntas a proposta faz que o pedido não respondia.
Nota de autoria: este texto seguiu o mesmo processo. A posição e as decisões são minhas; agentes escreveram e revisaram a partir da spec, e eu corrigi e aprovei.